Mapa de datos sensibles: descubrimiento y clasificación de datos
Descubre qué es un mapa de datos sensibles, cómo funciona el descubrimiento automatizado y por qué es clave.
La adecuada gestión de los datos ha ganado un peso creciente en las organizaciones. Las necesidades operativas y las exigencias regulatorias, en especial las relativas a la protección y la privacidad, han impulsado las iniciativas orientadas a disponer de una gobernanza del dato eficiente. Todas ellas comparten un requisito previo: saber qué datos se manejan y dónde están.
La mayoría de las organizaciones sabe que maneja datos sensibles en sus bases de datos. Muchas menos saben con precisión dónde están, en qué tablas, bajo qué nombres de campo y en qué formato. Con el tiempo, los sistemas de negocio se pueblan de aplicaciones dispares en tecnología, diseño y propósito, la documentación queda desactualizada al mismo ritmo al que se desarrollan nuevas capacidades, y los datos pasan por las manos de equipos que a menudo ya no están en la organización. El resultado es un modelo de datos extenso, con frecuencia del orden de miles de tablas, sobre el que nadie conserva una visión completa.
Las organizaciones guardan datos de interés en muchos soportes, pero son las bases de datos de las aplicaciones de negocio las que concentran la atención, por el volumen de información que manejan y por su importancia para la operación.
En este contexto, el mapa de datos sensibles responde a la pregunta inicial, definiendo la ubicación exacta de la información que la organización debe proteger. Es el paso previo e ineludible de cualquier iniciativa seria de gobierno del dato, cumplimiento normativo o preparación de entornos.
Qué es el mapa de datos sensibles
El mapa de datos sensibles es un inventario de la ubicación de los datos que requieren protección dentro de las bases de datos de una organización. Forma parte de un concepto más amplio, el mapa de datos de interés, que reúne todas las categorías de información relevante para el negocio.
Los datos de interés abarcan categorías como nombres y apellidos, documentos de identificación, direcciones postales, teléfonos, correos electrónicos, razón social, cuentas bancarias, tarjetas de crédito y débito, direcciones IP, URL y matrículas de vehículo. Los datos sensibles son el subconjunto de esa lista que, por su naturaleza o por exigencia regulatoria, concentra la mayor prioridad de protección.
Para cada campo identificado, un mapa útil registra cuatro elementos:
- La ubicación, expresada como esquema, tabla y campo, indica dónde reside la información.
- El tipo de dato sensible detectado y la evidencia que lleva a señalar el campo como candidato.
- La sugerencia de anonimización, el algoritmo recomendado para proteger el contenido de ese campo.
- El nivel de confianza, el porcentaje de registros leídos que cumple las condiciones para considerarse dato sensible, una medida de cuán probable es que el campo contenga realmente información sensible.
Junto a los campos que contienen información sensible, el mapa lista también aquellos que, sin contenerla, apuntan a su presencia en la tabla, de modo que la posibilidad de contener datos sensibles se conoce también de forma indirecta.
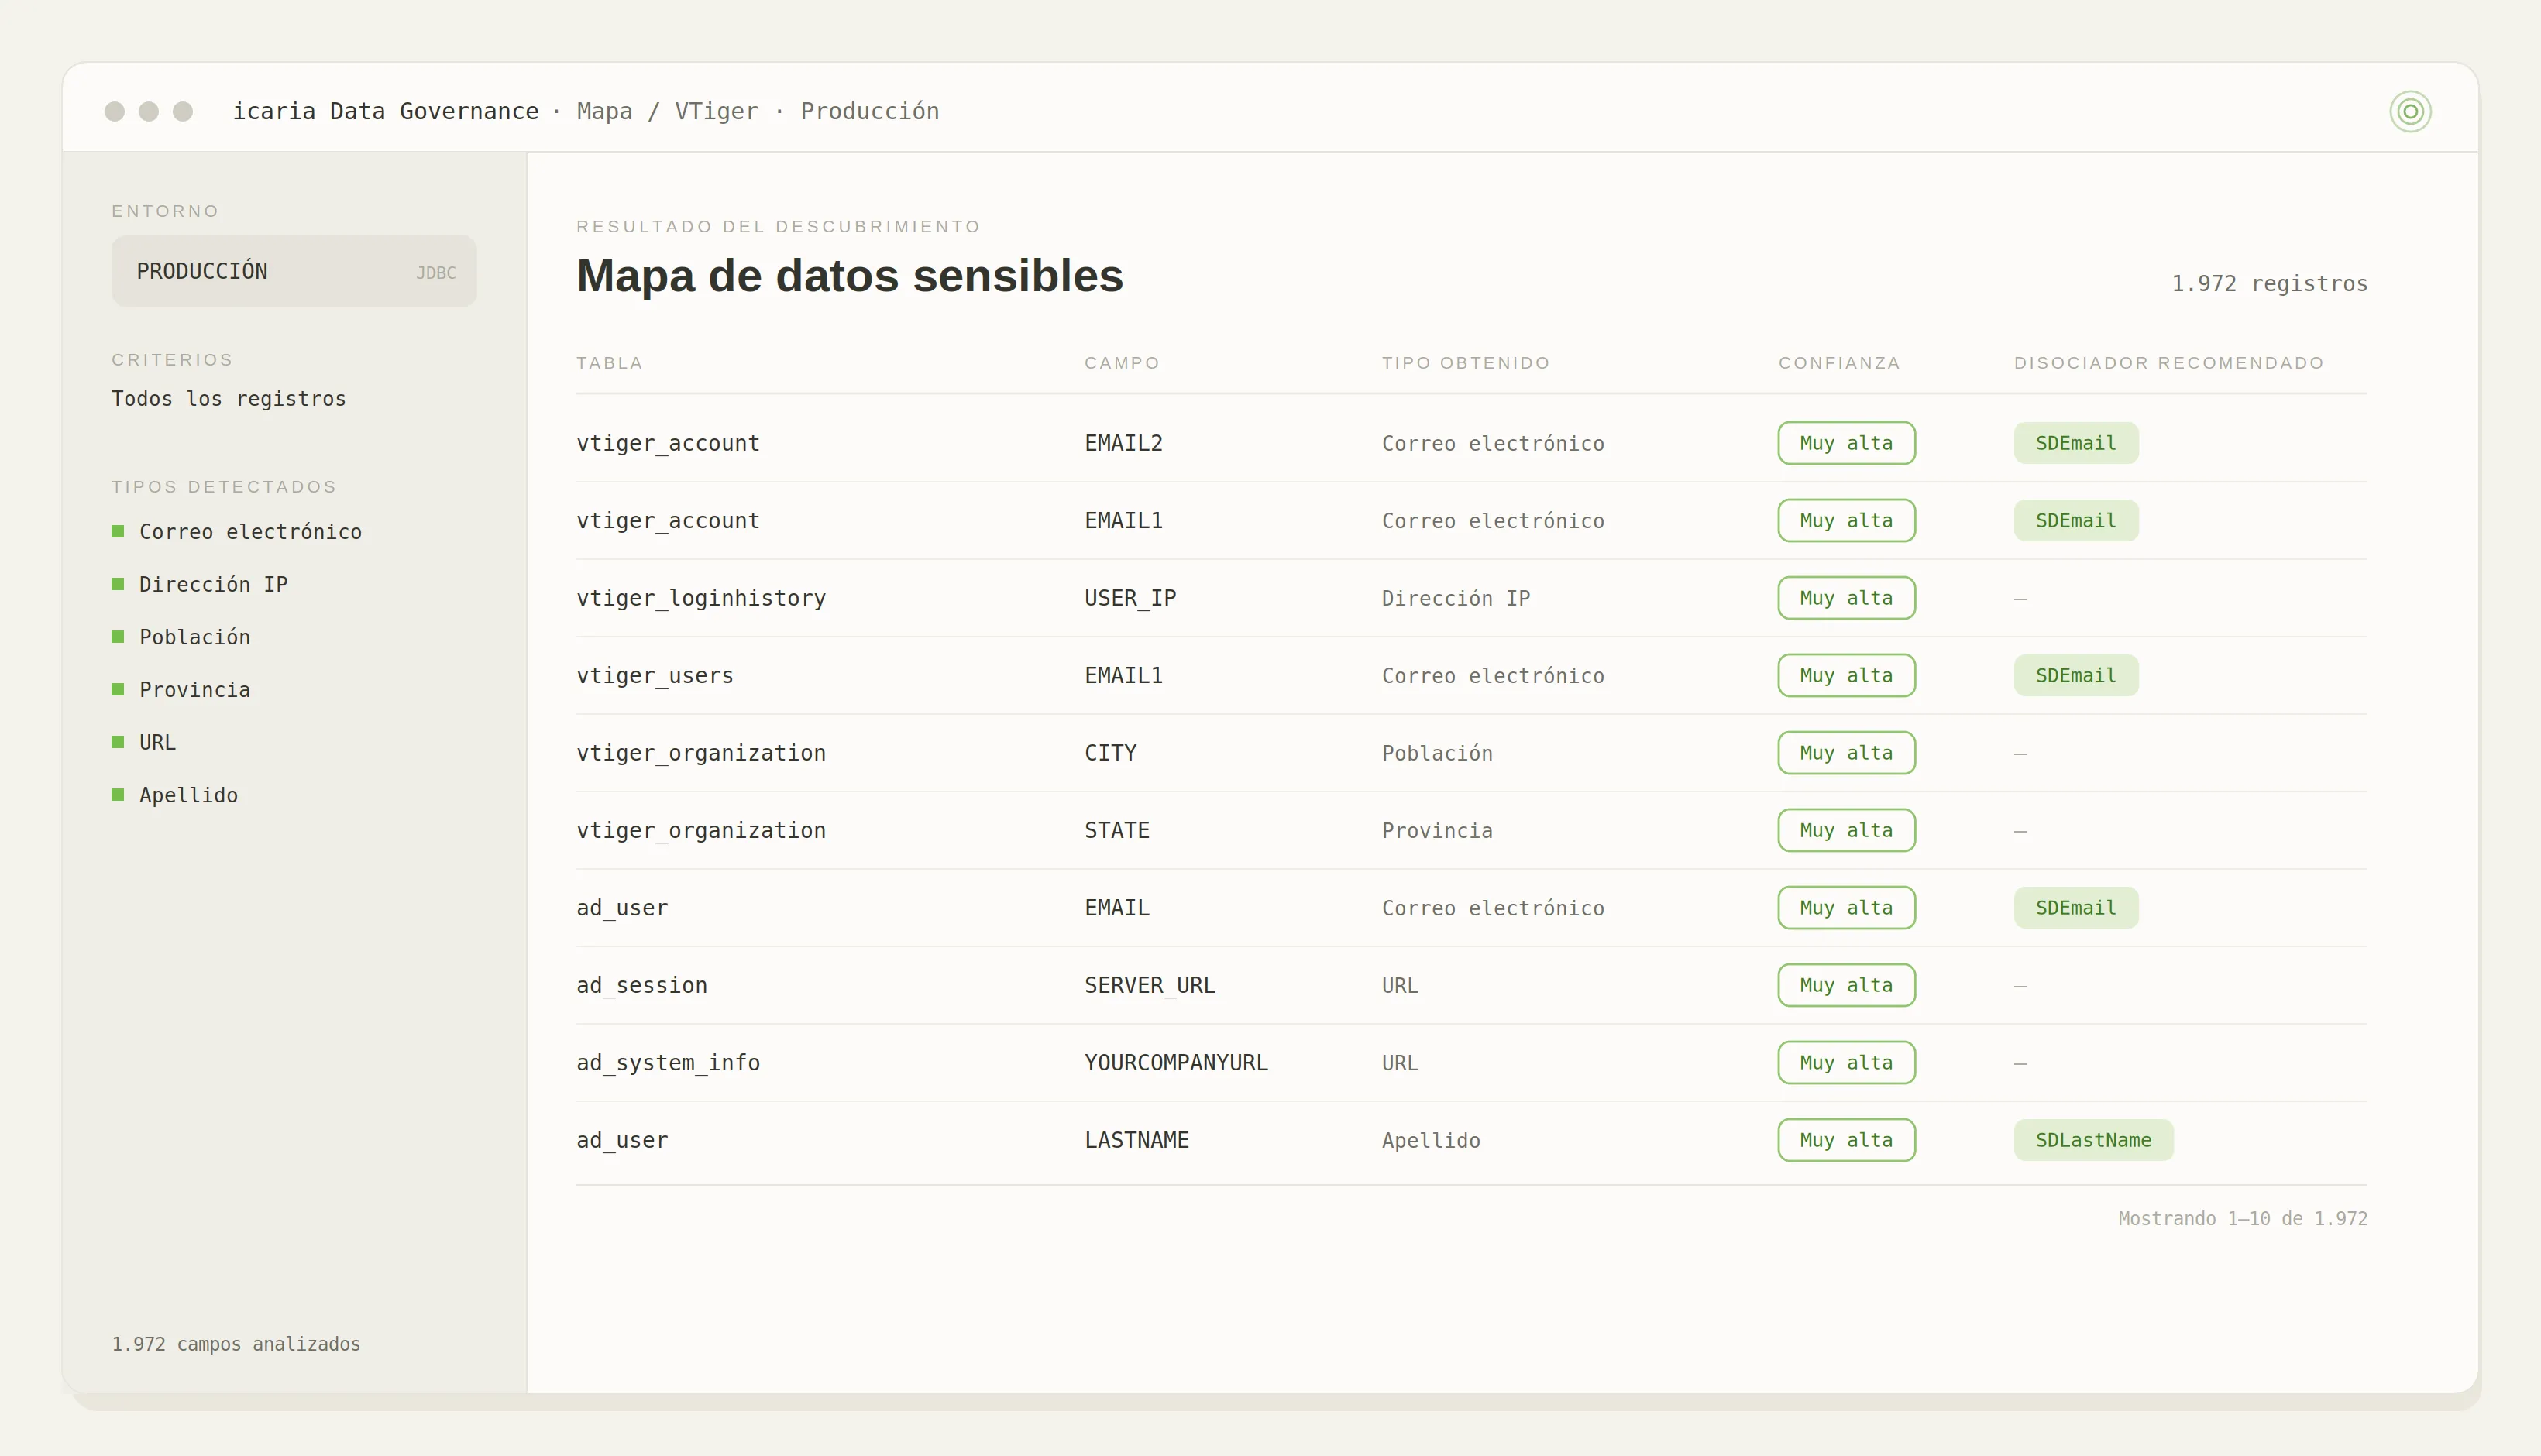
Elaborar y mantener este inventario a mano no resulta viable en una organización de cierto tamaño. Existen herramientas de gobierno del dato que lo construyen de forma automatizada, como icaria Data Governance a través de su módulo de Data Discovery, que localiza los datos de interés en las bases de datos de las aplicaciones de negocio. Los apartados siguientes detallan cómo la herramienta resuelve este problema, dónde busca la información, por qué el enfoque manual no basta, cómo funciona el descubrimiento y qué habilita el mapa una vez obtenido.
Dónde se buscan los datos
El descubrimiento se centra en las bases de datos de las aplicaciones de gestión de la organización, donde se concentra el grueso de la información sensible. Conviene precisar qué se entiende por aplicación de gestión en este contexto. Es el software empresarial que modela y ejecuta procesos de negocio repetibles, como ventas, compras, finanzas, inventario, recursos humanos o atención al cliente. Opera sobre datos maestros comunes, como productos o parámetros, y sobre datos de instancia, como clientes, contratos o cuentas. Estas aplicaciones, y las bases de datos que las sostienen, son el objeto del descubrimiento.
La facilidad y la precisión del descubrimiento dependen en buena medida de cómo cada aplicación almacena sus datos. Los productos estándar de mercado suelen presentar un modelo de datos normalizado y una nomenclatura y unos patrones de diseño estandarizados, lo que hace más directa la detección. Los desarrollos a medida tienden a una normalización más irregular y a divergencias en los patrones de diseño, y suelen contar con menos conocimiento documentado disponible, lo que exige más configuración e iteraciones para alcanzar un resultado fiable.
Es por ello que, al implantar icaria Data Governance, antes del primer análisis se conectan las fuentes de datos y se importa el modelo, es decir, las tablas, sus relaciones, campos y tipos. El alcance se acuerda con los equipos de las aplicaciones, que confirman qué tablas resultan relevantes. Involucrar a esos equipos desde el inicio facilita el desarrollo posterior del proyecto.
Obstáculos y dificultades del descubrimiento de datos manual
Abordar el descubrimiento de forma manual implica varios obstáculos a la vez:
- El tiempo. El modelo abarca con frecuencia miles de tablas y cambia al ritmo al que se desarrollan nuevas capacidades. Revisarlas campo por campo es lento y costoso, y un inventario elaborado a mano rara vez llega a estar al día.
- La dispersión entre múltiples aplicaciones. Una organización maneja numerosas aplicaciones y bases de datos dispares en tecnología, diseño y propósito, cada una con su nomenclatura y sus convenciones. El conocimiento está repartido y, a menudo, quienes diseñaron el modelo ya no están en la organización.
- El formato de almacenamiento. La manera en que se guardan los datos altera su estructura y dificulta reconocerlos por su patrón natural.
El tercer obstáculo merece un ejemplo concreto. Un mismo campo, llamado por ejemplo documento, guarda tanto el DNI como el pasaporte de un cliente. Como ambos no tienen la misma longitud, el más corto se rellena para que encaje. Ese relleno altera el formato del dato, que deja de coincidir con el patrón natural de un pasaporte. Es un caso menor y muy frecuente que revela el problema de fondo, la forma de almacenar los datos altera su estructura.
Algunos tipos requieren ajustes adicionales para lograr una detección precisa. Un identificador de cliente o de empleado de carácter numérico, por ejemplo, puede confundirse con otras claves numéricas autogeneradas y necesita reglas específicas. Reconocer correctamente los tipos de datos en estas condiciones exige un mecanismo capaz de adaptarse a las particularidades de cada organización.
Cómo funciona el descubrimiento automatizado de datos
El descubrimiento de datos de icaria Data Governance combina dos análisis complementarios. El primero examina el nombre de los campos de cada tabla. El segundo analiza el contenido real almacenado en ellas. Los dos resultados se evalúan en conjunto y producen un reporte con los campos que probablemente contienen datos sensibles y con aquellos que, sin contenerlos, sugieren su presencia. Una tabla con ciudad y código postal, por ejemplo, hace probable que exista también una dirección. El mapa aprovecha esa asociación para señalar de forma indirecta la posible presencia de información sensible.
El trabajo lo realizan los inspectores, agentes de detección configurables. icaria Data Governance incorpora inspectores genéricos para los tipos de datos más comunes y permite crear otros nuevos o modificar el comportamiento del proceso para ajustarse a las características de cada modelo. Sobre los inspectores se pueden configurar las palabras clave que indican alta probabilidad de información sensible, las cadenas de caracteres a ignorar (por ejemplo, para que un campo ID_CLIENTE numérico no genere un falso positivo cuando el nombre CLIENTE sí lo haría), la longitud esperada del campo y de los datos que contiene, la ponderación entre el análisis de nombre y el de contenido, y el umbral de sensibilidad a partir del cual se reporta un campo. Cuando varios inspectores señalan un mismo campo, prevalece el resultado de mayor confianza.
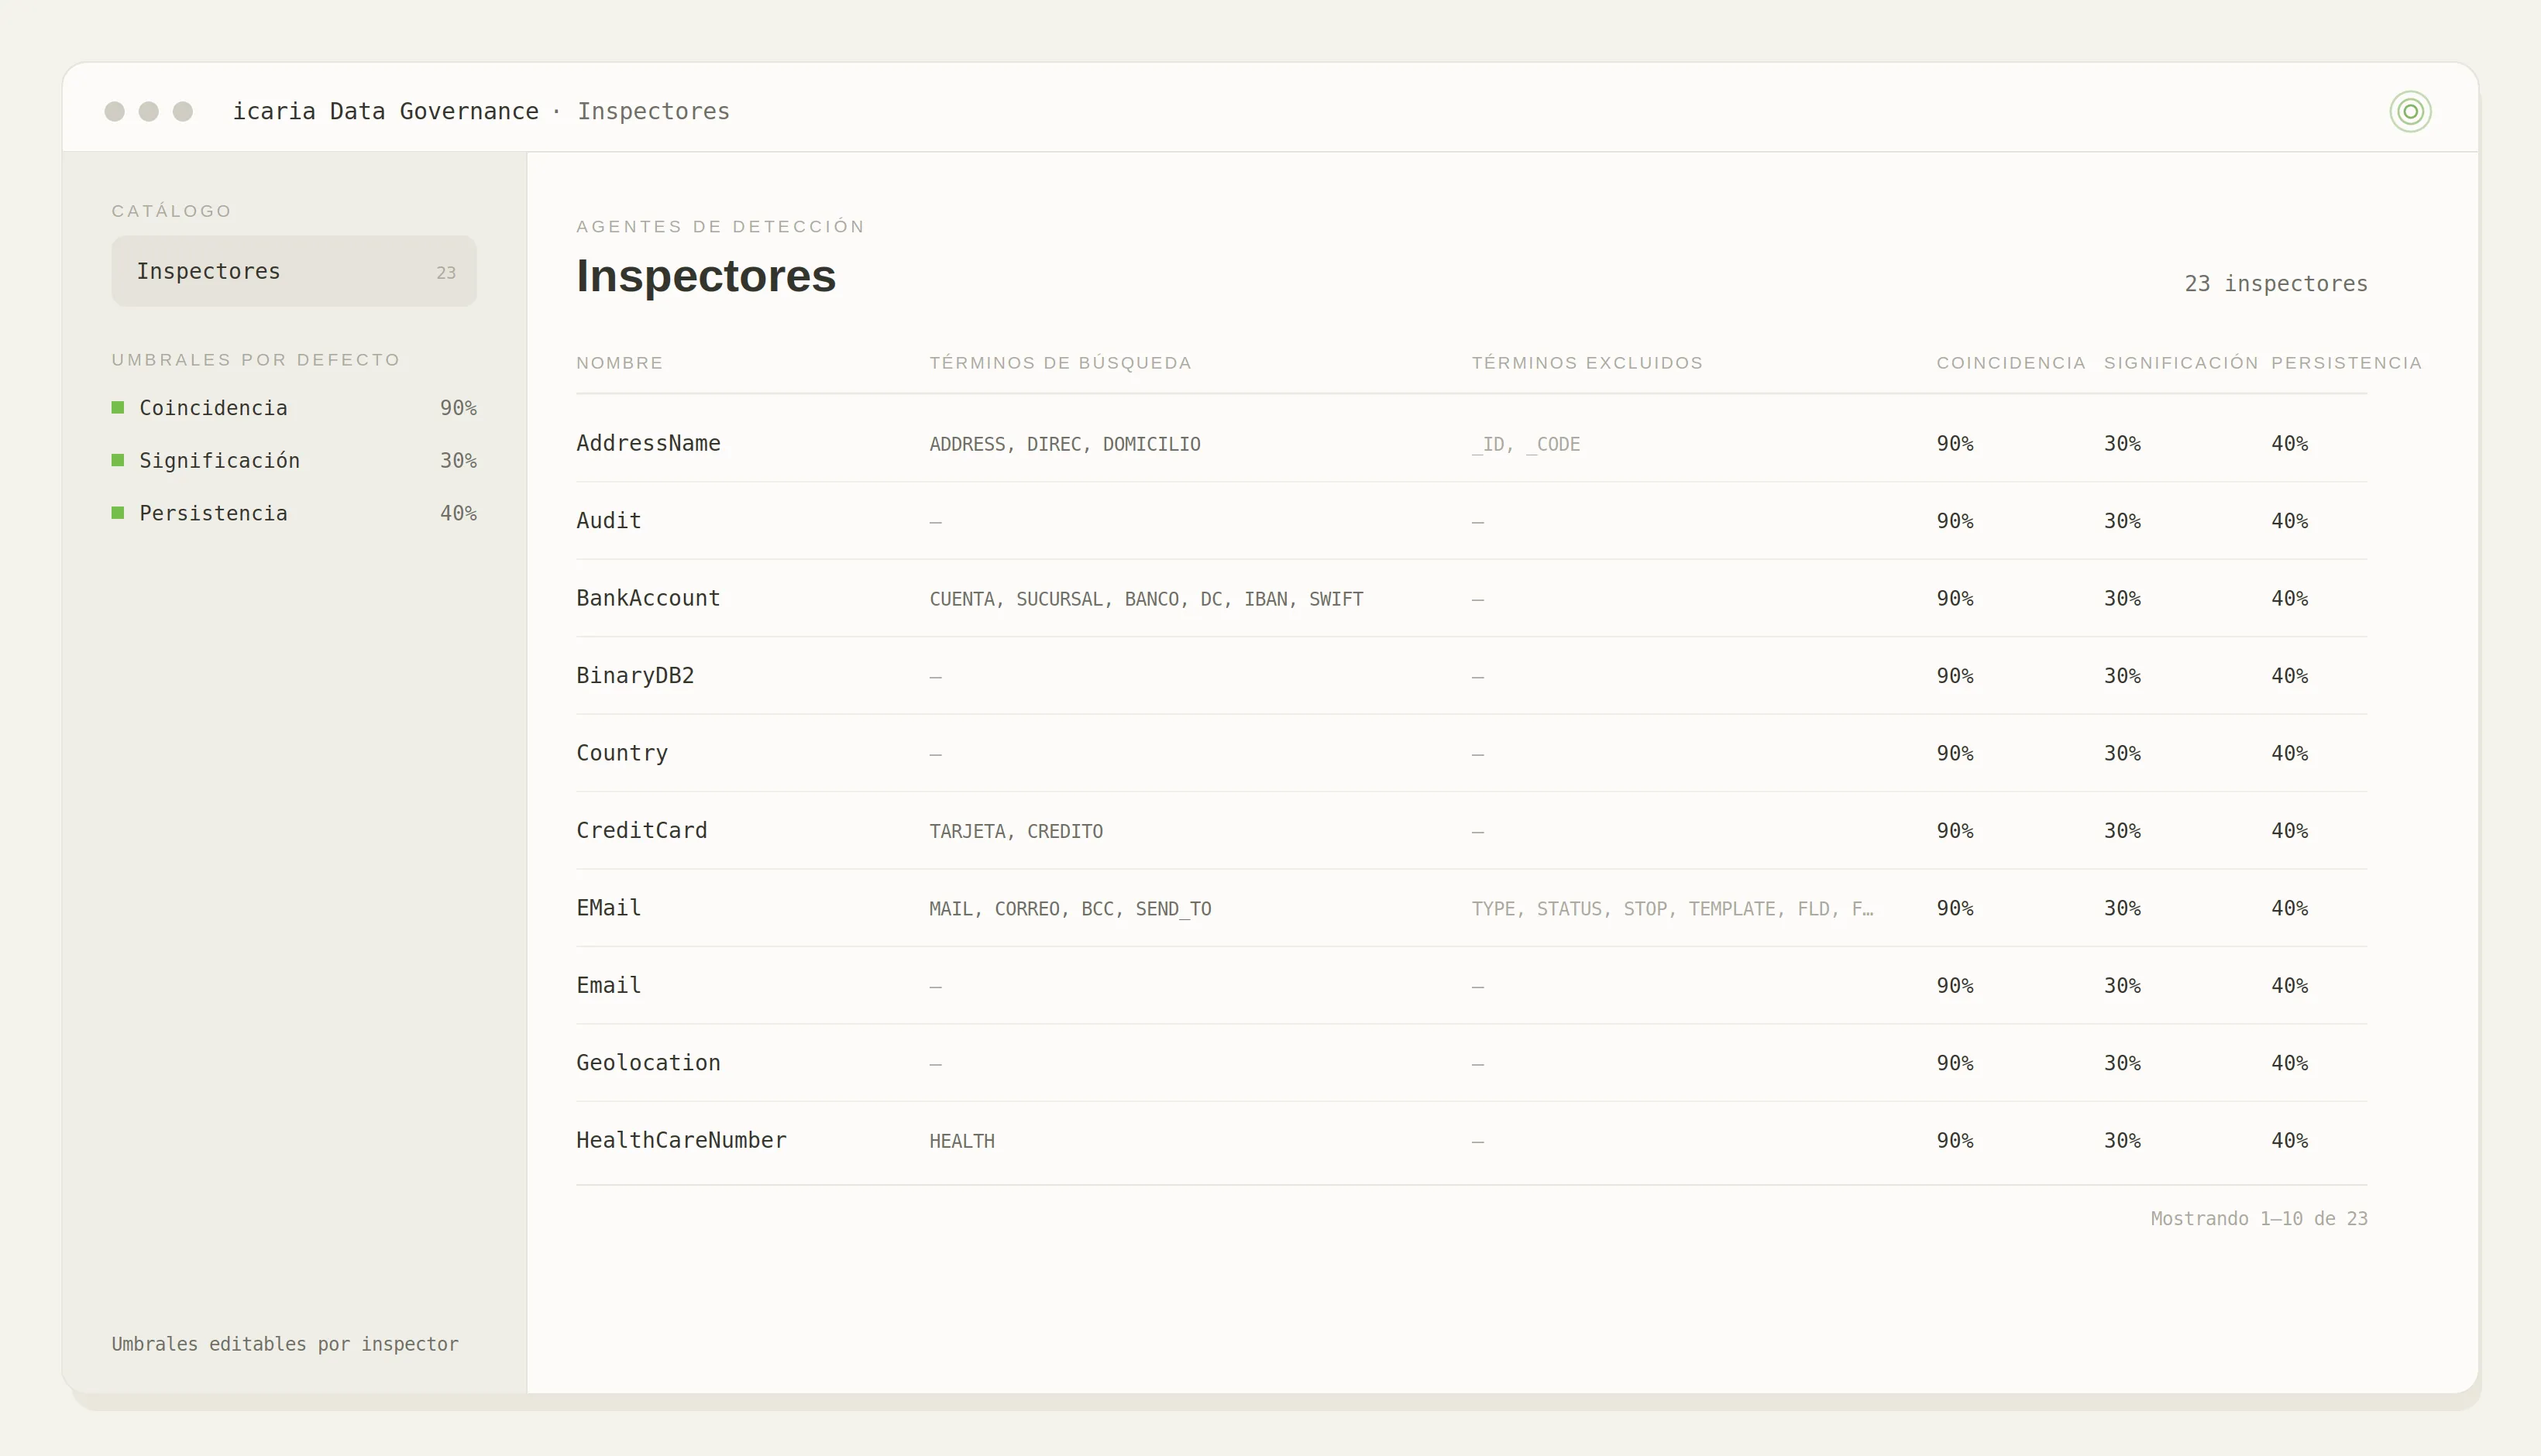
Para afinar la detección en campos cuya cabecera no identifica su contenido, los inspectores se entrenan con ejemplos. La organización aporta tablas y campos con información sensible que alimentan el reconocimiento del inspector. Cuando no se dispone de esos ejemplos, se recurre a una inspección manual de las tablas en las que el análisis previo detectó indicios, y a partir de ella se ajustan los inspectores.
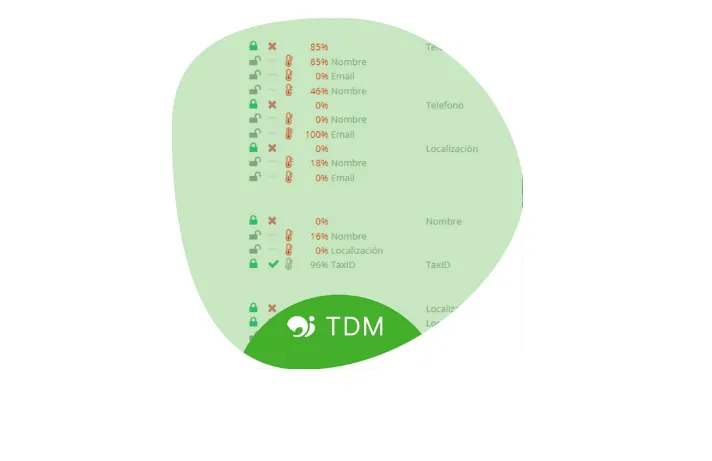
El resultado de este proceso es el ya mencionado mapa de datos sensibles. Se trata de un reporte que reúne, para cada base de datos examinada, la relación de campos candidatos con su ubicación, el tipo de dato detectado, la anonimización sugerida y el nivel de confianza, junto con los campos que apuntan de forma indirecta a información sensible. El mapa puede consultarse en la propia plataforma o exportarse a fichero para anotarlo, revisarlo o compartirlo con los equipos implicados.
Un proceso iterativo
El descubrimiento es un proceso iterativo, y la primera ejecución no entrega un resultado definitivo. Los primeros análisis producen falsos positivos y dejan campos sin detectar, porque cada organización almacena su información de una manera propia. A partir de esos resultados, de consultas rápidas sobre las tablas y del feedback de los equipos, se ajustan los parámetros y los inspectores para obtener reportes cada vez más precisos, que reducen los falsos positivos y dejan fuera el mínimo de campos posible. El criterio es prudente, se prefiere tolerar algunos falsos positivos antes que pasar por alto un campo sensible.
Suelen bastar dos o tres ciclos para reflejar con fidelidad el metamodelo, los estándares de nomenclatura y las peculiaridades de formato. Durante el proceso es habitual detectar datos almacenados de forma muy particular, que no siguen el estándar. Estos casos requieren personalizar los mecanismos de anonimización para que, una vez tratados, los datos sigan pareciendo tan reales como los de los entornos de producción.
Conviene ejecutar el análisis de forma periódica. Las bases de datos evolucionan con las necesidades del negocio, y con ellas aparece información nueva que puede requerir protección. Mientras los criterios de nombrado y de entrada de datos no cambien de forma drástica, los inspectores ya configurados siguen siendo válidos.
Del mapa al gobierno y la productificación de datos
El mapa de datos sensibles ordena y hace accionable el conocimiento sobre los datos de una organización. A partir de él, icaria Data Governance construye el metamodelo que describe cómo se representan los conceptos de negocio en cada fuente y almacén de datos, mejora la calidad, la supervisión y la atribución de responsabilidades sobre esos datos, y comparte los conceptos de negocio con los procesos que los representan, lo que facilita la alineación de la organización. Es la base sobre la que se apoya el gobierno del dato.
El mismo mapa habilita otras iniciativas que dependen de saber con exactitud dónde está la información. Entre destacan ellas la anonimización de entornos, la preparación de datos para desarrollo y prueba, la respuesta a las obligaciones de privacidad y la implementación de medidas para mejorar la calidad del dato.
Esto es especialmente importante porque, según Gartner, la mala calidad de los datos cuesta a las organizaciones una media de 12,9 millones de dólares al año.
En conclusión, conocer dónde están los datos sensibles es la condición previa para protegerlos y para gobernarlos. El módulo de Data Discovery de icaria Data Governance automatiza ese descubrimiento y lo mantiene actualizado a medida que las bases de datos cambian.