Gartner Hype Cycle for Privacy, 2026: de gestionar políticas a actuar sobre los datos
Descubre qué plantea Gartner sobre Data Discovery, Privacy Management, gestión de derechos y control del dato en el Hype Cycle™ for Privacy, 2026.
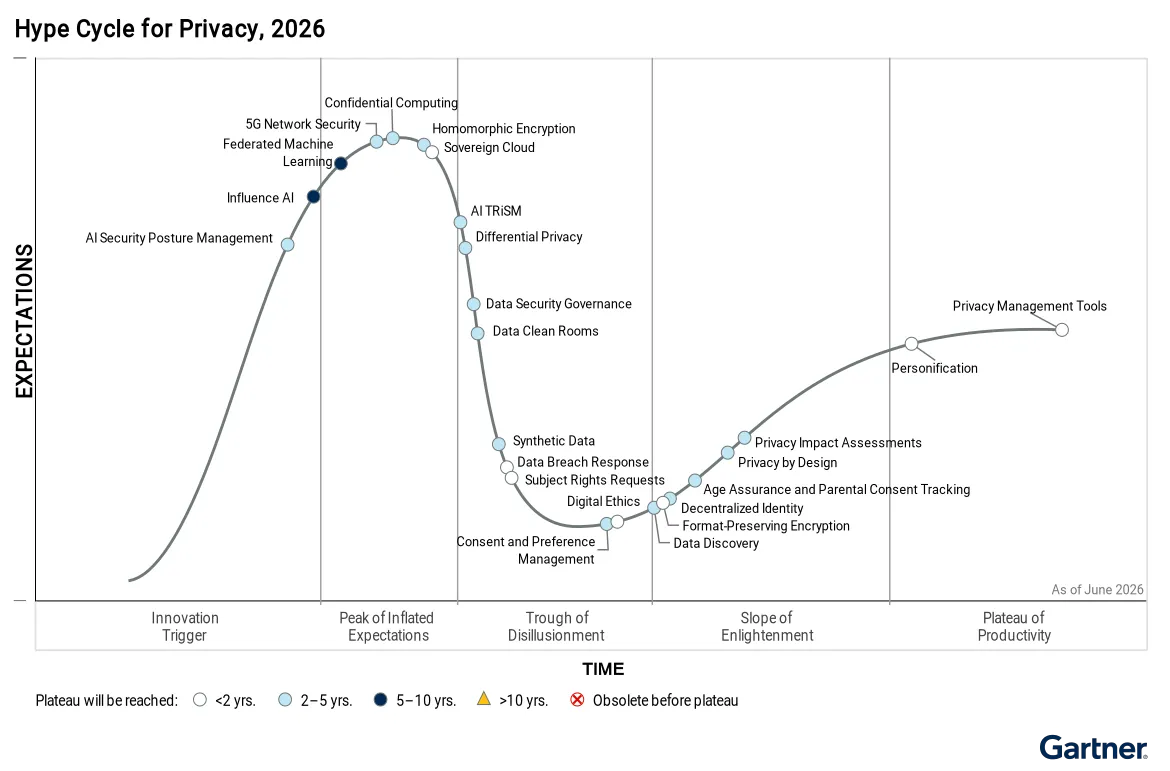
El Gartner® Hype Cycle™ for Privacy, 2026 analiza las tecnologías y capacidades que están evolucionando para responder a un escenario en el que gestionar la privacidad es cada vez más complejo.
La expansión de la inteligencia artificial, el crecimiento del volumen de información y la evolución de la regulación están aumentando la presión sobre las organizaciones. Pero el desafío no está únicamente en definir nuevas políticas o interpretar nuevas obligaciones.
Está también en ser capaces de aplicarlas sobre datos personales que pueden encontrarse distribuidos entre bases de datos, aplicaciones, servicios cloud, plataformas SaaS y sistemas legacy.
El informe recoge tecnologías relacionadas con ámbitos como Data Discovery, Privacy Management Tools, Subject Rights Requests o Privacy by Design, entre otras. Aunque responden a necesidades diferentes, muchas apuntan hacia un mismo problema: reducir la distancia entre la gestión de la privacidad y los sistemas donde realmente reside la información.
De hecho, una de las ideas relevantes del informe es que ni la tecnología ni las políticas, por sí solas, son suficientes para construir un programa maduro de privacidad. Las organizaciones necesitan combinar gobierno, procesos y políticas con capacidades que permitan conocer y actuar sobre el propio dato.
¿Qué implica este cambio y por qué el conocimiento del dato está adquiriendo tanta importancia? Lo analizamos a continuación.
El Hype Cycle refleja una privacidad cada vez más tecnológica y operativa
Durante mucho tiempo, buena parte del trabajo alrededor de privacidad se ha centrado en definir políticas, gestionar riesgos, documentar tratamientos y establecer procedimientos.
Sin embargo, el aumento de la complejidad tecnológica introduce una dificultad adicional: una política solo puede ejecutarse correctamente si la organización sabe sobre qué datos debe actuar.
Por ejemplo, una política de retención puede establecer que determinada información debe eliminarse una vez transcurrido un periodo concreto. Pero aplicarla exige saber qué información está afectada, en qué aplicaciones se encuentra y si existen copias en otros sistemas.
Lo mismo ocurre con la minimización, la protección de datos sensibles o una solicitud de supresión.
En todos estos casos, la política termina llegando al mismo punto: el dato.
Por eso Gartner plantea la necesidad de combinar dos tipos de capacidades complementarias: la gestión de privacidad y los controles centrados en los datos.
Data Discovery: saber sobre qué datos hay que actuar
Entre las capacidades que Gartner analiza se encuentra Data Discovery.
Su relevancia parte de un problema muy concreto: la información personal rara vez se encuentra concentrada en un único repositorio.
Una organización puede almacenar datos de una misma persona en un CRM, aplicaciones internas, bases de datos operativas, plataformas SaaS, sistemas históricos o copias utilizadas por otros procesos.
Con el tiempo, esa distribución dificulta mantener una visión fiable del dato.
Gartner señala que el Data Discovery puede ayudar a abordar esta dispersión en entornos híbridos, cloud y SaaS proporcionando visibilidad sobre la información distribuida, pero descubrir datos no debería convertirse en un fin en sí mismo.
Su utilidad aparece cuando permite contestar preguntas relevantes para privacidad:
- ¿Qué información personal y sensible tenemos?
- ¿En qué sistemas se encuentra?
- ¿Dónde existen datos relacionados o copias?
- ¿Qué información necesita protección?
- ¿Qué datos pueden estar afectados por una determinada política?
- ¿Podemos mantener este conocimiento actualizado sin reconstruirlo manualmente?
Responder estas preguntas permite transformar el discovery en un mapa de datos personales y sensibles.
El mapa de datos como base de una estrategia de privacidad
Disponer de un mapa del dato crea una capa de conocimiento común sobre la que pueden apoyarse diferentes procesos.
Por ejemplo, si una organización conoce dónde se encuentra determinada categoría de información y qué sistemas la utilizan, puede emplear ese conocimiento para orientar decisiones de:
- Minimización: identificando información que ya no resulta necesaria.
- Retención: relacionando los datos con los periodos establecidos por las políticas de conservación.
- Eliminación: localizando qué sistemas contienen la información sobre la que debe ejecutarse una acción.
- Protección: detectando datos personales o sensibles que requieren controles específicos.
- Gestión de derechos: identificando la información asociada a una persona cuando solicita acceso, rectificación o supresión.
El valor del mapa, por tanto, se encuentra en ser el punto de partida para actuar sobre ellos.
De descubrir información a gestionar su ciclo de vida
El propio Hype Cycle establece una conexión entre los resultados obtenidos mediante discovery y acciones posteriores como la retención, la eliminación o la minimización.
Debido a que una organización puede conocer perfectamente qué exige su política de conservación, pero si para ejecutarla necesita solicitar manualmente información a distintos departamentos, revisar varias aplicaciones y comprobar dónde permanecen las copias de los datos, el proceso difícilmente será escalable.
El objetivo debería ser que el conocimiento generado por el discovery pudiera alimentar decisiones posteriores sobre el ciclo de vida de la información.
De esta manera se pasa de: “Tenemos definida una política de privacidad” a: “Sabemos qué datos están afectados y podemos trasladar esa política hasta ellos.”
Ese es uno de los cambios más importantes cuando se aborda la privacidad desde una perspectiva centrada en el dato.
Los derechos de privacidad: cuando la política tiene que llegar hasta cada sistema
Las solicitudes de derechos muestran este problema de manera especialmente clara.
Cuando una persona solicita acceder a sus datos, rectificarlos o eliminarlos, recibir y registrar la solicitud solo constituye una parte del proceso.
Después hay que localizar la información. Si los datos están repartidos entre múltiples sistemas, pueden ser necesarias diferentes búsquedas y actuaciones por parte de IT, legal o los equipos de privacidad.
En una solicitud de supresión, por ejemplo, la organización puede necesitar:
- identificar todos los datos relacionados con la persona;
- determinar dónde se encuentran;
- diferenciar qué información puede eliminarse y cuál debe conservarse;
- ejecutar las acciones en cada sistema;
- y mantener evidencias de lo realizado.
Cuando todas estas tareas se realizan manualmente, el aumento del volumen de datos o solicitudes incrementa rápidamente la carga operativa.
Por eso las tecnologías relacionadas con Subject Rights Requests y otras capacidades de automatización forman también parte de la evolución que refleja el Hype Cycle.
También te puede interesar: Derecho de supresión: qué es, cuándo aplica y cómo cumplirlo
La automatización necesita llegar hasta el dato
La automatización de privacidad no debería limitarse a los formularios, workflows o procesos de aprobación.
Existe una oportunidad adicional en automatizar parte del trabajo técnico necesario para ejecutar las políticas.
Por ejemplo:
- descubrir información personal;
- clasificarla;
- localizarla entre diferentes fuentes;
- identificar los sistemas afectados por una acción;
- ejecutar determinados procesos sobre los datos;
- mantener trazabilidad sobre las acciones realizadas.
Esto resulta especialmente relevante cuando la privacidad debe gestionarse en organizaciones con un gran número de aplicaciones o con infraestructuras que han evolucionado durante años.
El objetivo, por lo tanto, es conseguir que las decisionesd e los responsables de privacidad, seguridad, legal o IT puedan ejecutarse de forma más consistente y con menor dependencia de operaciones manuales.
Un reto que aumenta con la regulación y la IA
Este problema adquiere todavía más relevancia en sectores intensivos en datos personales y sujetos a una fuerte regulación.
Banca, seguros, telecomunicaciones, salud o grandes compañías de servicios operan habitualmente con ecosistemas tecnológicos complejos y grandes volúmenes de información distribuida.
Al mismo tiempo, normativas como el RGPD, la LOPD o la Ley 21.719 de Chile están llevando a muchas organizaciones a revisar cómo trasladar sus obligaciones de privacidad a procesos técnicos y operativos.
Cuantos más procesos y casos de uso dependen de los datos, mayor importancia adquiere entender qué información existe, cuál es sensible, dónde está almacenada y bajo qué criterios puede utilizarse.
La privacidad, por tanto, empieza a depender cada vez más de una capacidad que también resulta fundamental para el gobierno del dato: mantener conocimiento y control sobre la información.
También te puede interesar: Ley 21.719: obligaciones técnicas para empresas
Cómo ayuda icaria Data Privacy a conectar las políticas con los datos
Este es precisamente uno de los ámbitos sobre los que trabaja icaria Data Privacy.
La solución ayuda a las organizaciones a identificar, clasificar y localizar información personal y sensible distribuida entre diferentes sistemas.
A partir de esa visibilidad, es posible construir una base sobre la que desarrollar procesos posteriores de privacidad y protección del dato.
Entre ellos:
- mantener un mapa de información personal y sensible;
- reducir la dependencia de procesos manuales de búsqueda;
- relacionar el conocimiento del dato con políticas de protección y ciclo de vida;
- facilitar la localización de información necesaria para gestionar derechos;
- mantener mayor trazabilidad sobre las acciones ejecutadas.
El objetivo es ayudar a reducir la distancia entre la política de privacidad que define qué debe hacerse y los sistemas donde esa decisión debe ejecutarse.
icaria Data Privacy, mencionada como Sample Vendor en el Hype Cycle for Privacy, 2026
En esta edición del Gartner® Hype Cycle™ for Privacy, 2026, icaria Data Privacy aparece mencionada como Sample Vendor.
La presencia de icaria Data Privacy se produce en un informe que refleja precisamente algunos de los retos sobre los que trabaja: discovery, conocimiento del dato, protección de la información y capacidad para trasladar los procesos de privacidad hasta los sistemas donde reside.
El Hype Cycle for Privacy, 2026 muestra un ecosistema de tecnologías con diferentes grados de madurez y orientadas a distintas necesidades. Pero detrás de muchas de ellas aparece una dependencia común: para proteger, minimizar, eliminar o gestionar los derechos asociados a un dato, primero es necesario saber que existe y dónde se encuentra.
El Data Discovery proporciona ese punto de partida.
El siguiente reto consiste en convertir ese conocimiento en una capacidad operativa: conectar los resultados con las políticas de privacidad y conseguir que las decisiones lleguen hasta los sistemas afectados.
Ahí es donde la privacidad puede evolucionar desde una gestión basada principalmente en procesos y políticas hacia un modelo con mayor control, trazabilidad y capacidad de ejecución sobre el dato.
¿Quieres conocer qué tecnologías y capacidades están marcando esta evolución? Descarga el Gartner® Hype Cycle™ for Privacy, 2026 y consulta el análisis completo.